結論
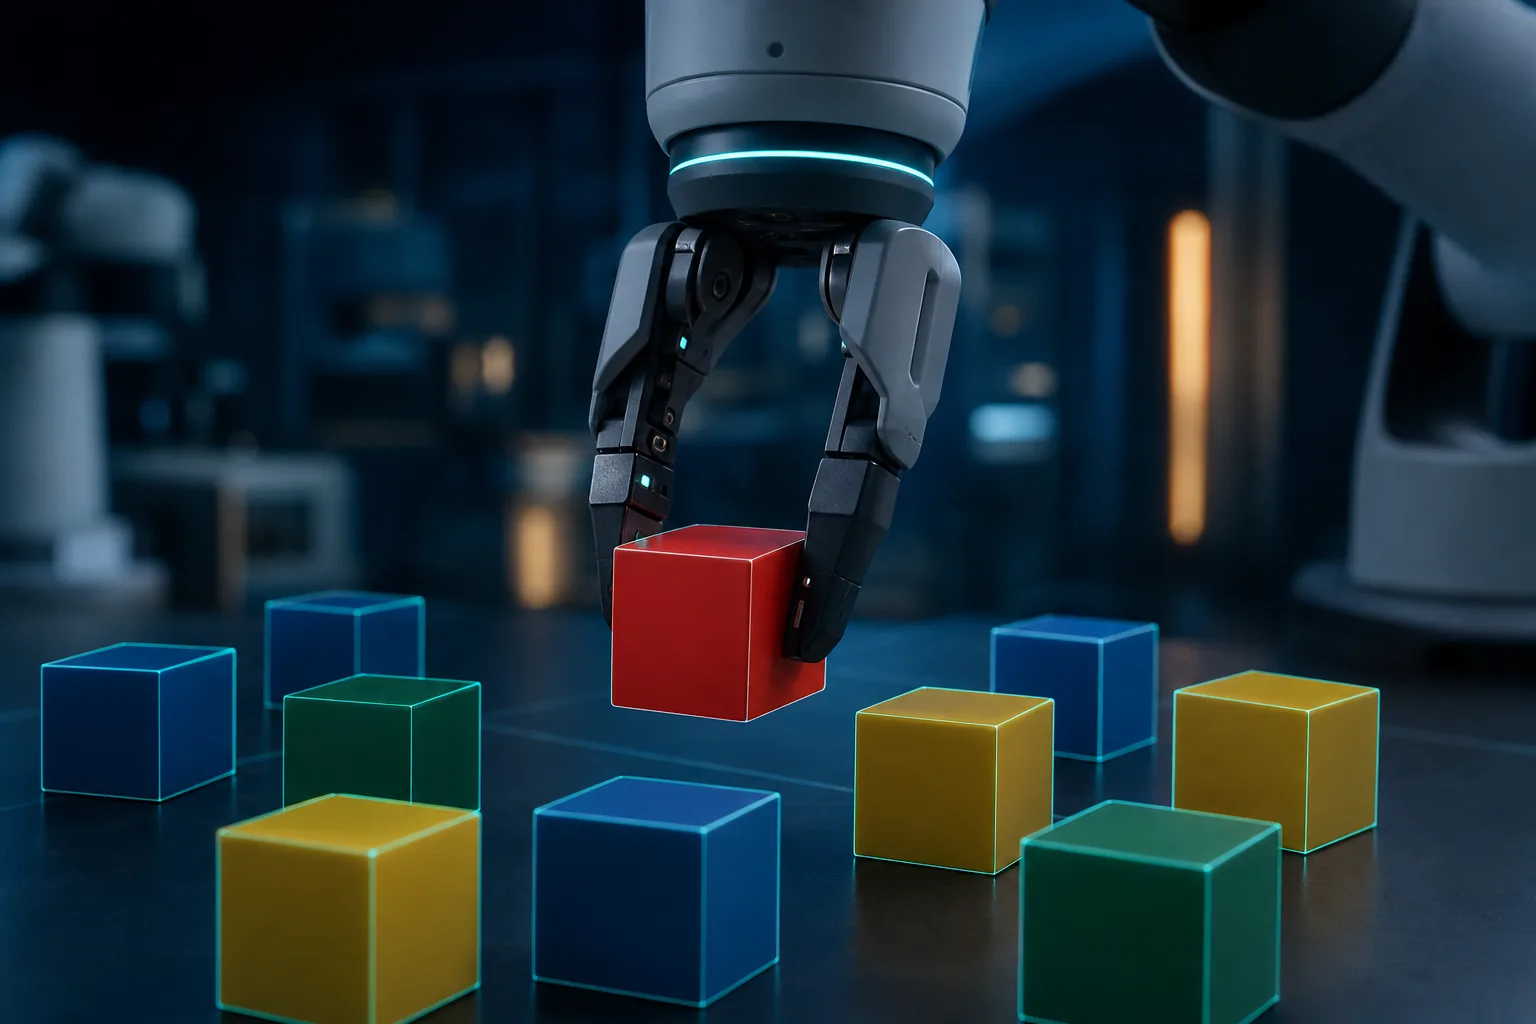
VLA モデルは、Vision(映像)・Language(言葉)・Action(動作)をひとつのモデルで扱う AI です。「棚の青い箱を取って」という指示とカメラの映像から、腕と手の動きを直接出力します。作業ごとに人がプログラムを書く従来の方法に比べ、新しい作業への応用が利きやすいのが特徴です。
この呼び名は、2023年7月に公開された論文「RT-2」が「このようなモデルの分類を vision-language-action models(VLA)と呼ぶ」と定義したことで広まりました。2024年6月には、97万件の実機のデモンストレーションで学習した70億パラメータのオープンソース VLA「OpenVLA」が公開され、研究機関や企業が自分の機体で試せるようになっています。
従来の方法との違い
| 従来のロボットプログラム | VLA モデル | |
|---|---|---|
| 動きの作り方 | 人が座標や手順を書く | データから学習する |
| 新しい作業 | 一から作り直す | 追加学習や指示の変更で対応 |
| 得意なこと | 決まった動きの正確な繰り返し | 形や位置が少し違う物への対応 |
| 弱点 | 環境の変化に弱い | 見たことのない状況で失敗する |
関係する言葉
- 模倣学習: 人が遠隔操作した動きのデータを真似させる学習。VLA モデルの学習データの多くはこの方法で集めます。
- 強化学習: 試行錯誤の結果に報酬を与えて動きを改善する学習。歩行の安定化などに使われます。
- Sim2Real: シミュレーションで学習した動きを実機に移すこと。実機でのデータ収集の手間を減らします。
- 基盤モデル: 大量のデータで学習し、さまざまな作業に応用できるモデル。VLA モデルはロボット向けの基盤モデルの一種です。
導入企業にとっての意味
- データを取れる現場が有利になる。 自社の作業のデータで調整したモデルは、自社に合った動きをします。
- 「学習済み」の言葉に注意。 どの環境・どの物で学習したかを確認し、自社の現場での検証を省かないでください。
- 二次開発に対応した機種を選ぶ。 モデルを載せ替える・調整するには、EDU 版など開発者向けの構成が要ります。